Giỏ hàng
0 Sản Phẩm

AI Inference (suy luận AI) là quá trình đưa một mô hình AI đã được huấn luyện vào sử dụng để phân tích dữ liệu mới và tạo ra kết quả. Nếu Training giúp mô hình “học”, Inference là bước giúp mô hình tạo ra giá trị trong các ứng dụng thực tế.
Từ chatbot, trợ lý AI, tìm kiếm thông minh đến nhận diện hình ảnh và AI Agent, phần lớn hoạt động tương tác với người dùng đều cần đến Inference. Khi doanh nghiệp đưa AI vào môi trường production, bài toán không còn chỉ là chọn một mô hình đủ mạnh. Hạ tầng phía sau phải đáp ứng đồng thời yêu cầu về tốc độ, khả năng xử lý, bộ nhớ, mở rộng và chi phí.
Theo Gartner, chi tiêu toàn cầu cho hạ tầng IaaS tối ưu cho AI được dự báo đạt 42,3 tỷ USD trong năm 2026. Đáng chú ý, chi tiêu cho workload Inference được dự báo đạt 23,3 tỷ USD, vượt 19 tỷ USD dành cho Training.
Vậy Inference là gì, hoạt động như thế nào và doanh nghiệp cần chuẩn bị hạ tầng cho AI Inference ra sao?
Inference là quá trình mô hình AI sử dụng những gì đã học để xử lý dữ liệu đầu vào và tạo ra kết quả mới. NVIDIA định nghĩa AI Inference là quá trình một mô hình đã được huấn luyện tạo ra output từ dữ liệu mới, phục vụ các tác vụ như dự đoán, phân loại và xử lý theo thời gian thực.
Có thể hiểu đơn giản:
Training = huấn luyện mô hình.
Inference = sử dụng mô hình.
Ví dụ, doanh nghiệp xây dựng một chatbot AI. Trong giai đoạn Training hoặc Fine-tuning, mô hình được huấn luyện bằng dữ liệu cần thiết. Khi chatbot đi vào sử dụng, mỗi câu hỏi của người dùng sẽ trở thành một request Inference. Hệ thống tiếp nhận câu hỏi, đưa dữ liệu vào mô hình và trả về câu trả lời.
Inference xuất hiện trong nhiều ứng dụng như chatbot, Generative AI, tìm kiếm thông minh, hệ thống đề xuất, nhận diện hình ảnh, xử lý ngôn ngữ tự nhiên và AI Agent.
>>> Xem thêm Server AI Là Gì? Tất Cả Những Điều Bạn Cần Biết Về Máy Chủ AI
Điểm khác biệt quan trọng nằm ở đặc tính công việc (workload). Training thường tạo ra các phiên xử lý lớn trong giai đoạn phát triển hoặc cập nhật mô hình. Inference lại có thể diễn ra liên tục khi ứng dụng được đưa vào vận hành.
Với doanh nghiệp, điều này khiến yêu cầu về hạ tầng cũng thay đổi. Một hệ thống Inference production không chỉ cần GPU đủ mạnh. Hệ thống còn phải xử lý đồng thời nhiều request, duy trì độ trễ thấp và có khả năng mở rộng khi lượng người dùng tăng.
Đặc biệt, sự phát triển của AI Agent đang làm workload Inference phức tạp hơn. Một yêu cầu của người dùng có thể kéo theo nhiều bước suy luận, gọi công cụ và xử lý dữ liệu thay vì chỉ tạo một câu trả lời duy nhất. Gartner dự báo chi phí Inference cho mỗi agentic workflow có thể tăng hơn 5 lần từ nay đến năm 2028.
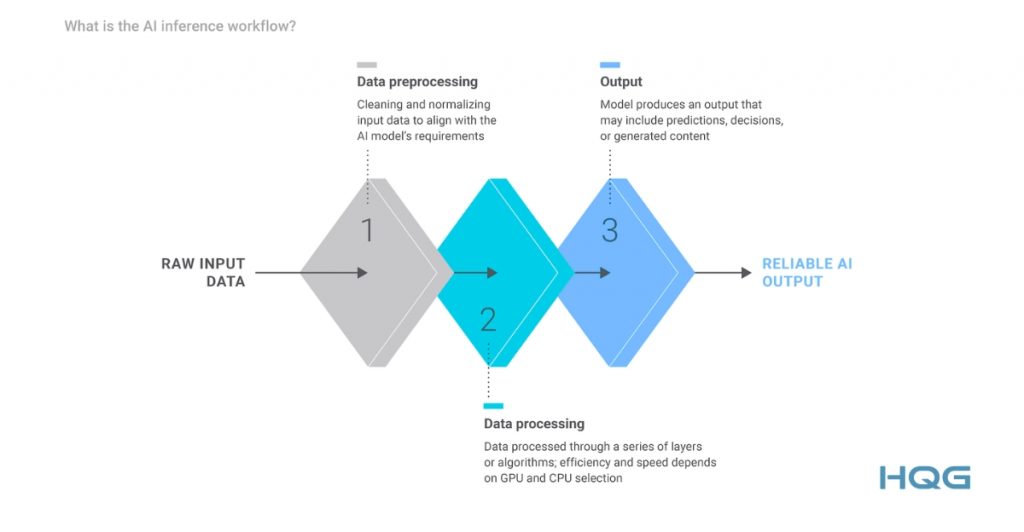
Một quy trình Inference cơ bản có thể được hình dung như sau:
Dữ liệu đầu vào → Model → Xử lý Inference → Kết quả đầu ra
Với Large Language Model (LLM), quy trình phức tạp hơn. Hệ thống phải xử lý prompt, tạo token và tiếp tục sinh từng token cho đến khi hoàn thành câu trả lời.
Prefill là lúc mô hình xử lý phần prompt hoặc context ban đầu. Decode là quá trình mô hình sinh các token tiếp theo. Hai giai đoạn này có đặc điểm tính toán khác nhau và vì vậy có thể cần cách tối ưu hạ tầng khác nhau.
Một thành phần quan trọng khác là KV Cache (Key-Value Cache). KV Cache lưu lại thông tin trung gian đã được tính toán để hệ thống có thể tái sử dụng trong các bước tiếp theo. Với các workload có context dài, KV Cache có thể chiếm lượng lớn bộ nhớ của accelerator và trở thành một yếu tố quan trọng khi thiết kế hệ thống Inference.
Vì vậy, đánh giá một hệ thống AI Inference không nên chỉ dựa trên tên GPU hoặc số lượng GPU.
Các chỉ số thường được quan tâm gồm latency, throughput, Time to First Token (TTFT) và tốc độ sinh token. Với hệ thống phục vụ nhiều người dùng, khả năng xử lý đồng thời cũng rất quan trọng.
Đây cũng là lý do các kỹ thuật như continuous batching, quantization, speculative decoding và KV Cache optimization ngày càng phổ biến. Chúng giúp tận dụng tốt hơn tài nguyên phần cứng và giảm thời gian hoặc chi phí xử lý trong những workload phù hợp.
Ở cấp độ ứng dụng, Inference còn có thể kết hợp với Retrieval-Augmented Generation (RAG). Khi đó, hệ thống không chỉ chạy LLM mà còn phải thực hiện embedding, truy xuất dữ liệu từ vector database, re-ranking và sau đó mới đưa thông tin vào LLM để tạo câu trả lời.
MLPerf Inference v6.1 đã bổ sung benchmark End-to-End RAG và các workload Agentic, cho thấy việc đánh giá Inference đang dần chuyển từ một model riêng lẻ sang các pipeline AI hoàn chỉnh.
>>> Xem thêm: NVIDIA A100 vs H100 – GPU nào phù hợp cho các tác vụ AI?
Một hệ thống AI Inference Infrastructure cần được thiết kế dựa trên workload thực tế thay vì chỉ chọn GPU có hiệu năng cao nhất.
GPU là thành phần xử lý chính trong nhiều workload Generative AI và LLM Inference. Khi lựa chọn GPU, doanh nghiệp cần xem xét đồng thời VRAM, hiệu năng tính toán, memory bandwidth và khả năng kết nối giữa các GPU.
VRAM đặc biệt quan trọng với các mô hình lớn. Hệ thống cần đủ bộ nhớ cho model weights, KV Cache và các thành phần khác trong quá trình xử lý.
Với model lớn không thể chạy trên một GPU, doanh nghiệp có thể cần kiến trúc Multi-GPU. Khi đó, tốc độ kết nối giữa các GPU cũng ảnh hưởng đến hiệu quả tổng thể.
Inference không chỉ phụ thuộc vào GPU.
CPU đảm nhiệm nhiều tác vụ điều phối, tiền xử lý và hậu xử lý dữ liệu. RAM hỗ trợ việc lưu trữ dữ liệu và các tiến trình của hệ thống. Storage cần đáp ứng nhu cầu lưu model, dataset, cache và các dữ liệu liên quan.
Với hệ thống RAG, storage và database còn đóng vai trò quan trọng trong việc cung cấp dữ liệu cho pipeline Inference.
Khi triển khai Multi-GPU hoặc nhiều server, network trở thành một phần quan trọng của hạ tầng.
Băng thông và độ trễ mạng có thể ảnh hưởng đến quá trình trao đổi dữ liệu giữa các thành phần. Với workload quy mô lớn, doanh nghiệp có thể cần high-speed networking và kiến trúc kết nối phù hợp để tránh network trở thành bottleneck.
Phần cứng mạnh chưa đảm bảo hệ thống Inference đạt hiệu quả cao.
Inference cần một software stack phù hợp để quản lý model serving, batching, scheduling, memory và request. Các công nghệ phổ biến trong hệ sinh thái này gồm NVIDIA Triton, TensorRT-LLM, vLLM và các inference framework khác.
vLLM hiện hỗ trợ nhiều kỹ thuật tối ưu như continuous batching, prefix caching, speculative decoding, quantization và distributed inference.
Do đó, một hệ thống AI Inference hoàn chỉnh cần được nhìn theo chuỗi:
AI Application → Model → Inference Software → GPU/Accelerator → Server → Network → Storage
Thiếu một mắt xích, hiệu năng thực tế có thể không đạt như kỳ vọng.
Doanh nghiệp nên bắt đầu từ workload, sau đó mới xác định cấu hình phần cứng.
Bước đầu tiên là xác định model và ứng dụng. Doanh nghiệp cần biết đang chạy LLM, Vision AI, Speech AI hay mô hình đa phương thức. Kích thước model, context length và yêu cầu về độ chính xác cũng cần được xác định.
Tiếp theo là xác định yêu cầu về latency và throughput. Một chatbot phục vụ nhân viên nội bộ sẽ có yêu cầu khác với hệ thống AI phục vụ hàng nghìn khách hàng cùng lúc. Hệ thống real-time cũng cần ưu tiên latency khác với workload xử lý batch.
Đây là yếu tố ảnh hưởng trực tiếp đến số lượng GPU và cách tổ chức server.
Với workload nhỏ hoặc giai đoạn thử nghiệm, Cloud GPU có thể là lựa chọn linh hoạt. Doanh nghiệp có thể thuê tài nguyên theo nhu cầu mà không phải đầu tư toàn bộ hạ tầng ngay từ đầu.
Khi workload ổn định và nhu cầu sử dụng tăng, doanh nghiệp có thể cân nhắc AI Server hoặc GPU Server riêng. Mô hình này phù hợp khi cần kiểm soát tài nguyên, dữ liệu, phần mềm và hiệu năng của hệ thống.
Với workload lớn hơn, kiến trúc có thể mở rộng thành nhiều GPU hoặc nhiều server. Khi đó cần tính đến GPU interconnect, network, storage, load balancing, monitoring và khả năng mở rộng.
Một yếu tố khác không nên bỏ qua là benchmark trước khi triển khai production. MLPerf Inference là một trong những bộ benchmark được sử dụng để đánh giá hiệu năng hệ thống Inference theo phương pháp có tính tái lập. Phiên bản v6.1 hiện đã bao gồm nhiều workload từ LLM, VLM đến RAG và Agentic Inference.
Doanh nghiệp cũng nên đánh giá cost per request hoặc cost per token, thay vì chỉ nhìn giá mua GPU. Một GPU đắt hơn có thể phù hợp nếu giúp xử lý nhiều request hơn hoặc giảm thời gian xử lý. Ngược lại, cấu hình quá cao so với workload sẽ làm tăng chi phí đầu tư mà không mang lại hiệu quả tương ứng.
Cuối cùng là khả năng mở rộng. Hạ tầng Inference nên được thiết kế để có thể tăng thêm GPU, server hoặc tài nguyên khi lượng request tăng. MLPerf Inference v6.1 ghi nhận một submission quy mô tới 512 GPU, cho thấy Inference ngày càng được triển khai theo mô hình scale-out thay vì chỉ tập trung vào một thiết bị đơn lẻ.
Khi AI chuyển từ giai đoạn thử nghiệm sang production, bài toán lớn hơn không còn là “model có chạy được không”.
Doanh nghiệp cần trả lời nhiều câu hỏi hơn:
Model phản hồi nhanh đến đâu?
Có thể phục vụ bao nhiêu người dùng đồng thời?
GPU có được sử dụng hiệu quả không?
Chi phí cho mỗi request hoặc token là bao nhiêu?
Hệ thống có thể mở rộng khi workload tăng không?
Dữ liệu và model có được bảo vệ không?
Đây là lý do Inference đang trở thành một phần quan trọng của chiến lược AI Infrastructure. Gartner dự báo Inference sẽ chiếm 55% chi tiêu cho AI-optimized IaaS trong năm 2026 và đạt 59% vào năm 2027.
Đồng thời, benchmark cũng đang thay đổi theo hướng phản ánh các workload thực tế hơn. MLPerf Inference v6.1 bổ sung RAG và Agentic Inference, trong khi các benchmark hiện có tiếp tục mở rộng sang những mô hình và kiến trúc AI mới.
Điều này cho thấy một xu hướng rõ ràng: hạ tầng AI không chỉ cần đủ mạnh để chạy model. Hạ tầng cần được tối ưu để phục vụ model hiệu quả trong môi trường thực tế.
Với doanh nghiệp đang triển khai AI, việc lựa chọn giữa Cloud GPU, GPU Server riêng, Multi-GPU Server hay hệ thống AI Infrastructure cần dựa trên model, workload, số lượng người dùng, yêu cầu latency, khả năng mở rộng và ngân sách.
Để đưa AI từ môi trường thử nghiệm vào production, doanh nghiệp cần một hạ tầng phù hợp với workload thực tế.
HQG cung cấp giải pháp AI Server và hạ tầng GPU, hỗ trợ doanh nghiệp từ tư vấn cấu hình đến xây dựng hệ thống phục vụ các workload AI.
Tùy nhu cầu, doanh nghiệp có thể triển khai GPU Server cho LLM Inference, Generative AI, RAG, Computer Vision, AI Agent hoặc các workload AI chuyên biệt.
Thay vì chỉ lựa chọn GPU dựa trên thông số, HQG có thể cùng doanh nghiệp xác định yêu cầu về model, VRAM, hiệu năng, số lượng người dùng, khả năng mở rộng và kiến trúc hệ thống để xây dựng cấu hình phù hợp.
Doanh nghiệp đang cần triển khai AI Inference, GPU Server hoặc hạ tầng AI? Liên hệ HQG để được tư vấn giải pháp phù hợp với workload và nhu cầu thực tế.
Nhà cung cấp Máy chủ, thiết bị lưu trữ IBM, Dell, HPE và các linh kiện, phụ kiện; Dịch vụ IT Outsource, cho thuê thiết bị, nâng cấp, bảo trì hệ thống – Giải pháp CNTT toàn diện.
Website: https://hqg.vn/
Fanpage: Facebook | LinkedIn | YouTube | TikTok
Hotline: 0922 999 111 | Email: info@hqg.vn
Trụ sở: 8 Nguyễn Duy, Phường Gia Định, TP. Hồ Chí Minh, Việt Nam.
VPGD Hồ Chí Minh: Lô O, số 10, Đ.15, KDC Miếu Nổi, Phường Gia Định, TP. Hồ Chí Minh.
VPGD Đà Nẵng: 30 Nguyễn Hữu Thọ, Phường Hải Châu, Đà Nẵng.
VPGD Hà Nội: 132 Vũ Phạm Hàm, Phường Yên Hoà, Hà Nội.